AI per accelerarela ricerca trascrittomica.
Geneversity: milioni di profili RNA per riconoscere le cellule, stimarne le proporzioni ed esplorare nuovi biomarcatori.
dataset single-cell
profili single-cell
dataset bulk RNA
campioni microarray e RNA-seq
Milioni di profili.Nuove domande biologiche.
Gli esperimenti trascrittomici generano un patrimonio enorme ma eterogeneo. Il progetto raccoglie e standardizza dati provenienti da microarray, bulk RNA e single-cell per esplorare le relazioni fra espressione genica, tipi cellulari, tessuti e malattie.
- Single-cell RNA-seq
- Bulk RNA
- Multitask learning
Dentro la piattaforma.
Tre viste collegano selezione delle cellule, composizione dei campioni e confronto dell’espressione genica. Le interfacce riprendono il prototipo del progetto; i profili nei grafici sono esemplificativi.
Dalla singola cellula al suo contesto.
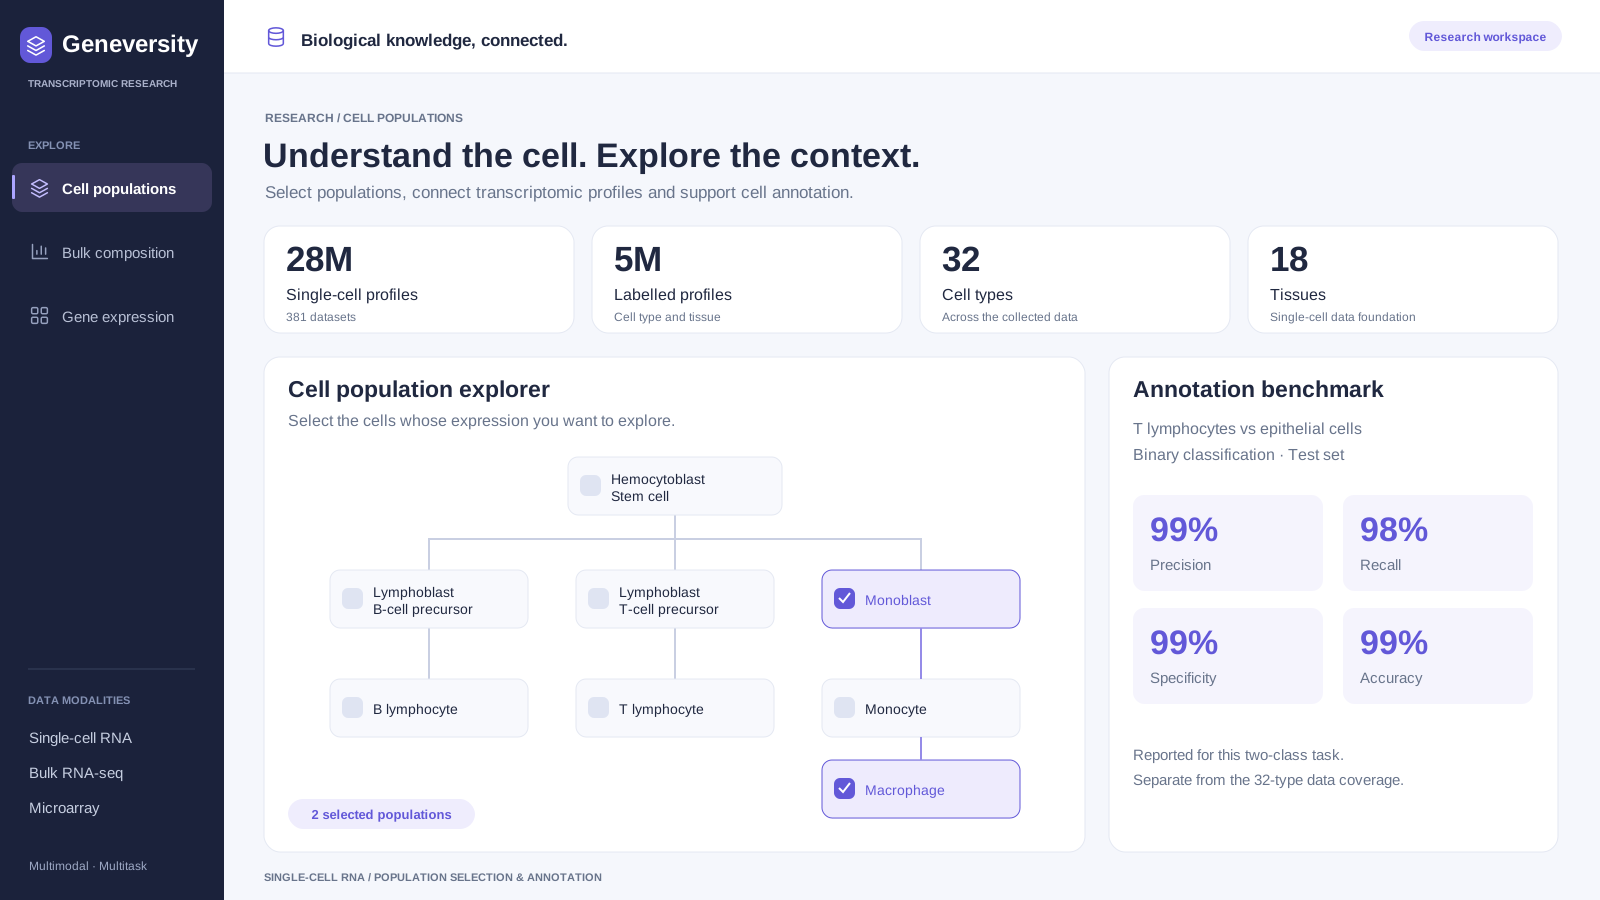
Il selettore riprende le popolazioni cellulari del prototipo e le collega alla base single-cell: 28 milioni di profili, di cui 5 milioni annotati. Il pannello affianca i risultati del test binario tra linfociti T e cellule epiteliali: una misura specifica, distinta dalla copertura dei 32 tipi cellulari.
Leggere le popolazioni dentro un tessuto.
Un campione bulk raccoglie il segnale di più popolazioni cellulari. Il progetto esplora come stimarne le proporzioni attraverso il deep learning. La vista confronta campioni e componenti: le barre sono esemplificative; i 317 dataset e i 26 mila campioni descrivono la base dati del progetto.
Confrontare gruppi. Formulare nuove ipotesi.
Si selezionano le popolazioni di interesse e si confronta l’espressione genica tra gruppi, mantenendo visibile il contesto. La vista riprende i due gruppi del prototipo, da 120 e 35 individui. Gene X e le barre illustrano il confronto: non rappresentano biomarcatori validati.
Ciò che abbiamo progettato.
L’obiettivo è apprendere da più modalità di dati e affrontare più compiti con un framework condiviso: annotazione delle cellule, stima delle proporzioni e ricerca di biomarcatori. Una base organizzata permette ai ricercatori di passare dalla preparazione dei dati alle domande biologiche.
Organizzare la conoscenza biologica
Raccolta, standardizzazione e annotazione dei dati per tipo cellulare e tessuto: la qualità della base informativa precede il modello.
Apprendere da più modalità
Un approccio multitask a dati single-cell e bulk RNA per affrontare classificazione cellulare, stima delle proporzioni cellulari e ricerca di biomarcatori.
Rendere esplorabili le ipotesi
Il prototipo permette di selezionare le popolazioni cellulari e confrontare l’espressione genica tra gruppi. Il contesto del campione accompagna la lettura delle differenze e aiuta a formulare ipotesi su una patologia o uno stato biologico.
Microarray, bulk RNA e single-cell
Standardizzazione + deep learning multitask
Annotazione cellulare e ipotesi sui biomarcatori
Una base di ricerca.Due scale di osservazione.
Dati single-cell e bulk RNA riuniti in una base strutturata per l’analisi trascrittomica.
Dal profilo cellulare al tessuto.
Single-cell
381 dataset e 28 milioni di profili, di cui 5 milioni etichettati per tipo cellulare e tessuto.
- 32 tipi cellulari
- 18 tessuti
- Linfociti T e cellule epiteliali
Bulk RNA
317 dataset con 26.000 campioni microarray e RNA-seq etichettati per tipo cellulare e tessuto.
- 15 tessuti
- Oltre 20 sottotipi di tessuto e tipi cellulari
- 16 malattie, fra cui artrite reumatoide e psoriasi
Dai dati RNA.Alle domande biologiche.
Un percorso che collega preparazione dei dati, apprendimento ed esplorazione.
Rendere confrontabilifonti diverse.
Microarray, bulk RNA-seq e single-cell vengono raccolti e standardizzati. Tipo cellulare e tessuto organizzano le annotazioni disponibili.
- Microarray
- Bulk RNA-seq
- Single-cell RNA
Una base dati strutturata su cui apprendere.
Più modalità.Più compiti biologici.
Il framework di deep learning collega dati multimodali e obiettivi diversi con un approccio multitask. L’annotazione cellulare è una delle applicazioni studiate.
- Tipi cellulari
- Proporzioni
- Biomarcatori
Rappresentazioni condivise da esplorare su compiti differenti.
Una domanda biologica.Un confronto da approfondire.
Il ricercatore seleziona le popolazioni e confronta gruppi e profili di espressione. Le differenze osservate orientano le ipotesi e i successivi approfondimenti sperimentali.
- Popolazioni
- Gruppi
- Espressione genica
Ipotesi di ricerca contestualizzate, da verificare.
Un test mirato.Risultati misurati.
Il progetto include un classificatore binario di linfociti T e cellule epiteliali: precisione 99%, recall 98%, specificità 99% e accuratezza 99% sul test set del confronto binario.
Il test riguarda soltanto la classificazione binaria tra linfociti T e cellule epiteliali. Questi risultati non misurano tutte le applicazioni del framework e non costituiscono una validazione clinica.
Le domande che guidano la ricerca.
- Quali tipi cellulari sono presenti nel campione?
- Come cambia l’espressione di un gene fra due gruppi?
- Quali segnali meritano un approfondimento come possibili biomarcatori?
Ciò che rendepossibile.
- Una base single-cell e bulk RNA raccolta, standardizzata e annotata per tipo cellulare e tessuto.
- Un test binario di annotazione cellulare con precision 99%, recall 98%, specificity 99% e accuracy 99%.
- Un ambiente di esplorazione per confrontare popolazioni e formulare nuove ipotesi sui biomarcatori.
Trasformiamo i tuoi datiin nuove domande di ricerca.
Trasformiamo i tuoi dati in nuove domande di ricerca.
Raccontaci il tuo progetto
Estrazione automatizzata dalle perizie immobiliari.
Carichi le perizie. L’AI estrae dati catastali, occupazione, difformità e valori economici, pronti per la scheda immobile.